
集団プライバシー
 Hiroshi Miyashita
ー改正個人情報保護法の統計作成等の特例について考えるー
Group Privacy: On Japan's Statistical-Creation Exception under the 2026 Amendment to the Act on the Protection of Personal Information
This post examines group privacy in the context of the 2026 amendment to Japan's Act on the Protection of Personal Information (APPI), focusing on the new exception for ‘statistical creation and related activities’. Data protection law has traditionally centred on identifiable individuals. Yet, AI and big-data analytics can construct new groups by extracting patterns from large datasets without directly identifying particular individuals. Such group-level knowledge may then be used for profiling, pricing, employment, advertising, or other decisions affecting individuals inferred to belong to a particular group.
While the GDPR remains primarily individual-centred, the EU AI Act expressly includes ‘groups of persons’ within the scope of certain prohibited AI practices, and its social scoring rules recognise the risk of detrimental treatment of whole groups and their exclusion. It also draws on the CJEU’s SCHUFA judgment to highlight the importance of upstream regulation of scoring and inference where group-derived patterns may shape decisions affecting individuals.
Against this background, the post identifies three issues in Japan's statistical-creation exception: group privacy, identification and inference risks, and the implications of its harm-based approach for EU-Japan adequacy. It argues that the absence of direct identification does not necessarily eliminate effects on individuals. The central question is how the principle of respect for individual person under the APPI should respond when group-based inference and decision-making significantly affect individuals.
「個人」情報保護法
個人情報保護法は、個人を起点とした法制度です。
誰の個人情報であり、どのような本人の権利があり、誰が当該個人のデータを利用できるかを規律しています。では、「個人に関する情報」でなければ、本人同意なしに個人情報を自由に第三者が利用できるのでしょうか。
個人の権利利益の保護は、「集団」を見ずして、「個人」だけに着目すればよいのでしょうか。
AI・ビッグデータの時代には、この個人だけに着目した発想だけでは捉えきれない問題が生じることがあります。特定の個人を一次的に識別しなくても、大量のデータから特定の属性をもつ「傾向又は性質」を抽出することで集団が構成され、その集団への評価や取扱いを通じて個人への不利益や害悪が及ぶ経路があります。
この問題について、2026年7月10日に成立した改正個人情報保護法の統計作成等の特例を取り上げてみることにします。
集団プライバシー(group privacy)
「集団プライバシー」には一義的な定義があるわけではありません。ここでは、個人のプライバシーの総和としてではなく、AIやビッグデータによる規則性の抽出を通じて新たに構成されるクラスター(clusters)に関連するプライバシーの問題として捉えることとします。AIは既存の集団への働きかけのみならず、データの分類と予測を通じて新たなクラスターを構成することができます。
こうしたデータ分析によって構成された集団は、人間が事前に定義した集団類型に縛られていないこと、本人の自覚を必要としないこと、そして個人を直接識別する情報がなくても集団の分類ができることを特徴としています。たとえば、個別化された保険料やローン金利の設定等の価格差別、おすすめの商品が一定の集団にしか提示されない機会の制限、一定の集団に政治広告やニュースがおすすめとして表示される情報の集合的な配信などがあります。統計の市場価値は、顧客のセグメンテーション、リスク評価、スコアリング、購買予測、動的価格設定等を通じて集団にどう働きかけるかという点に見出されます。集団に対する評価や取扱いは、その集団に属すると推論・予測された個人にも波及しやすくなります。個人を直接識別することなく集団を構成し、その集団への評価や意思決定を通じて個人に影響を及ぼすという、AI時代の集団プライバシーの問題があります。
このような統計の隠れた脅威は、1983年ドイツ国勢調査判決にもすでに示唆されていました。特定可能な個人と集団との関連性が問われた国勢調査について、特に「小規模な集団」に関する情報の場合、目的外利用のリスクに対応する措置の必要性が指摘されていました。その後のドイツ憲法裁判所の一連の判例(Rasterfahndung II判決及び自動化データ分析判決)は、集団的属性に基づくプロファイリングやアルゴリズムを用いた人格関連性を有する知識の生成によって、統計的に把握される集団の分類や推論が、結果として個人に対する評価や意思決定に作用する構造が情報自己決定権に影響することを示しています。
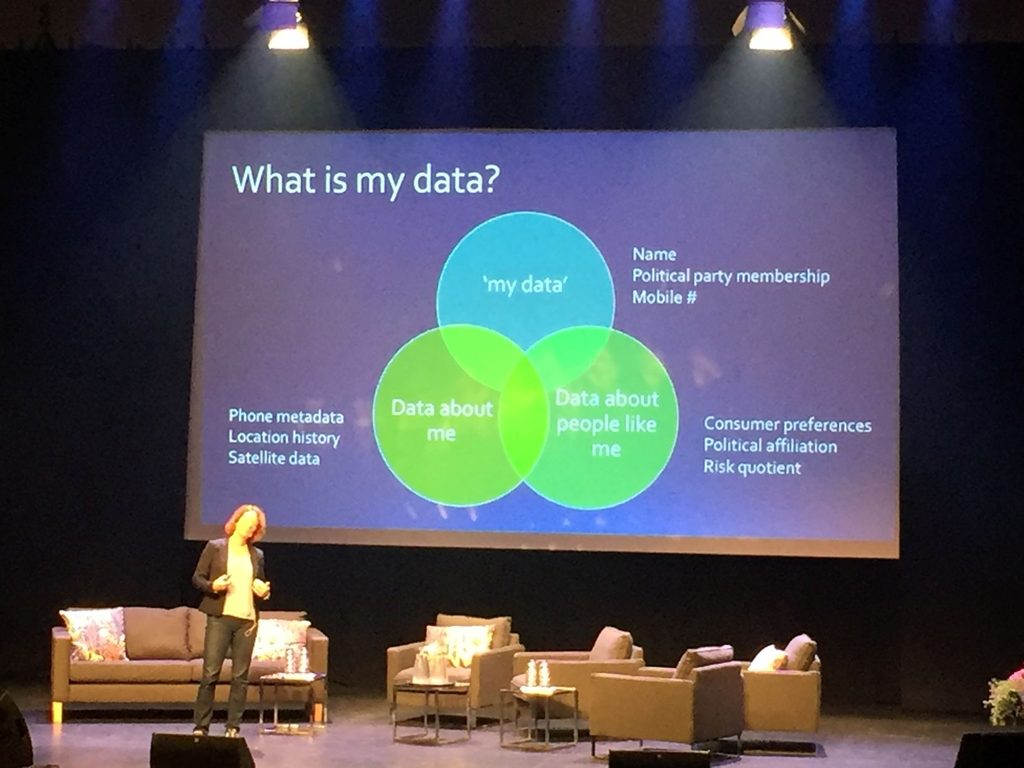
Tilburg University Professor Linnet Taylor(当時助教)によるGroup Privacyの発表 (MyData Conference, 1 September 2017, Helsinki)
EUのGDPRとAI法:個人の保護と集団の保護
EUは、個人を中心とするデータ保護法と集団を規制対象に含むAI規則が、それぞれ異なる側面から機能しています。
GDPRは、識別可能な「個人」としての「データ主体」を保護するために設計された枠組みです。その中核的規定である、22条の自動化された意思決定についても、データ主体に関する決定を規律対象とする個人を起点に置いた構造です。
これに対し、AI法5条は、禁止AIシステムの慣行の対象として、「自然人(natural person(s))」及び「集団(groups of persons)」を明示的に分けて規定することにより、AIによる分類・推論によって構成される集団を含め規制対象に組み込みました。とりわけ、ソーシャルスコアについては、既知、推論又は予測された個人的特徴に基づいて自然人又は集団を評価・分類し、その結果として「一定の自然人又は集団」に不利益な取扱いをもたらすAIシステムが禁止されています。個人のみならず、「集団全体」(AI法前文31項)に対する不利益取扱いが一定の集団の排除につながりうることを示しています。
このように、EUのデジタル法制度は、必ずしも集団プライバシーを承認しているわけではありませんが、既存の個人中心のデータ保護法に加えて、集団を明示的に規制対象に含むAI法を組み合わせることによって、AIによる分類・推論が集団を介して個人に及ぼす不利益に対処しています。
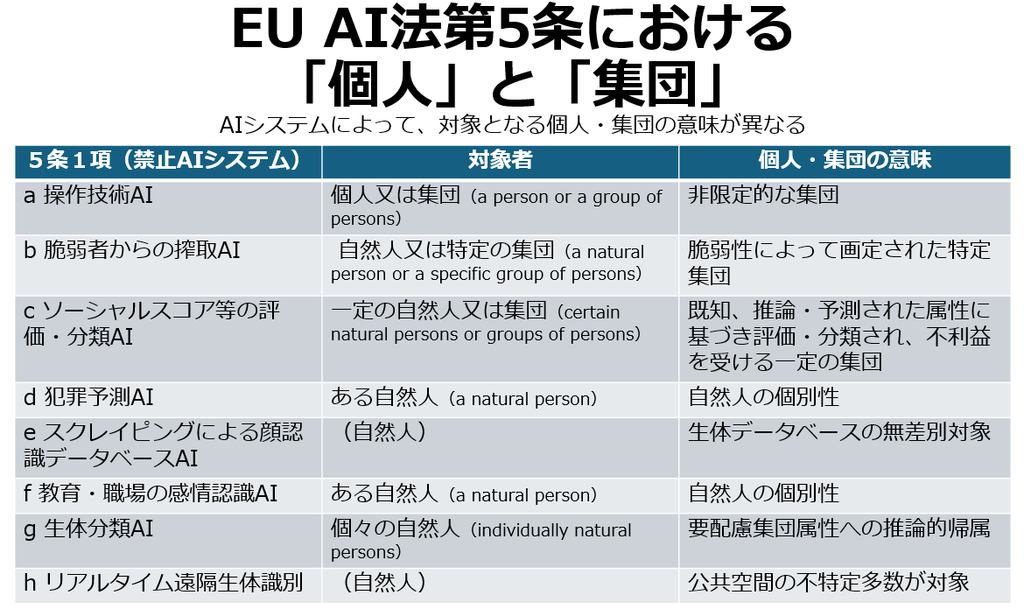
統計作成等の定義に係る論点
以上を踏まえて、日本の統計特例の定義について考えてみます。改正個人情報保護法2条13項は次のように規定しています。
「この法律において『統計作成等』とは、統計の作成その他の大量の情報から当該情報を構成する要素に係る情報を抽出して分類、比較その他の解析を行うことにより、当該大量の情報の傾向又は性質に係る情報(個人に関する情報であるものを除く。)を作成する行為のうち、個人の権利利益を害するおそれが少ないものとして個人情報保護委員会規則で定めるものをいう。」
この定義には、少なくとも三つの論点が含まれています。
第1に、集団プライバシーについてです。定義では、「大量の情報の傾向又は性質に係る情報」の作成を対象としています。まさにAIモデルの開発やAIシステムの利用において新たに生成される集団を構成する要素となる情報です。EUのAI法が「個人又は集団」を規制対象としているのに対し、日本の統計特例は「個人に関する情報を含まない」ことを一つの要件としています。そのため、個人との対応関係が排斥された統計情報から集団が新たに構成され、当該集団への評価や意思決定を通じて個人に影響が及ぶ場合を、どこまで規制の対象として捉えるのかが問題となります。
第2に、(再)識別リスクの論点です。定義は「個人に関する情報」を除外していますが、「個人を識別することができる情報」ではない点が重要です。EDPB匿名化ガイドラインも集計データが一見すると集団についての情報にすぎない場合でも、そこから個人に関する情報を推論でき、その処理によって当該個人が他者と異なる取扱いを受ける具体的可能性がある場合には、その情報が当該個人に関連し得ることを認めています(para17)。したがって、統計特例における「個人に関する情報」の除外を考える際には、個人を直接識別できるかだけでなく、そこからどのような個人に関する推論が可能となるかにも留意する必要があります。
第3に、EUの十分性との関係で重要な「害悪アプローチ(harm-based approach)」の論点です。統計特例は、個人の権利利益へのリスク判定基準とする枠組みではなく、「害するおそれが少ないもの」という「害悪アプローチ」を採用しています。EUは、欧州議会の日本の十分性決定に関する決議において、保有個人データの範囲に関する日本の害悪アプローチがGDPRと整合しないことを指摘し、これを受けて、補完的ルールが創設されたり、その後令和2年改正では短期保存データの保有個人データに関連する害悪アプローチが廃止された経緯があります。統計特例における「害するおそれ」の判定基準に集団的害悪やリスク評価の視点を組み込めないまま運用すれば、十分性決定への影響を含め、国際的整合性の問題が生じうることになりかねません。
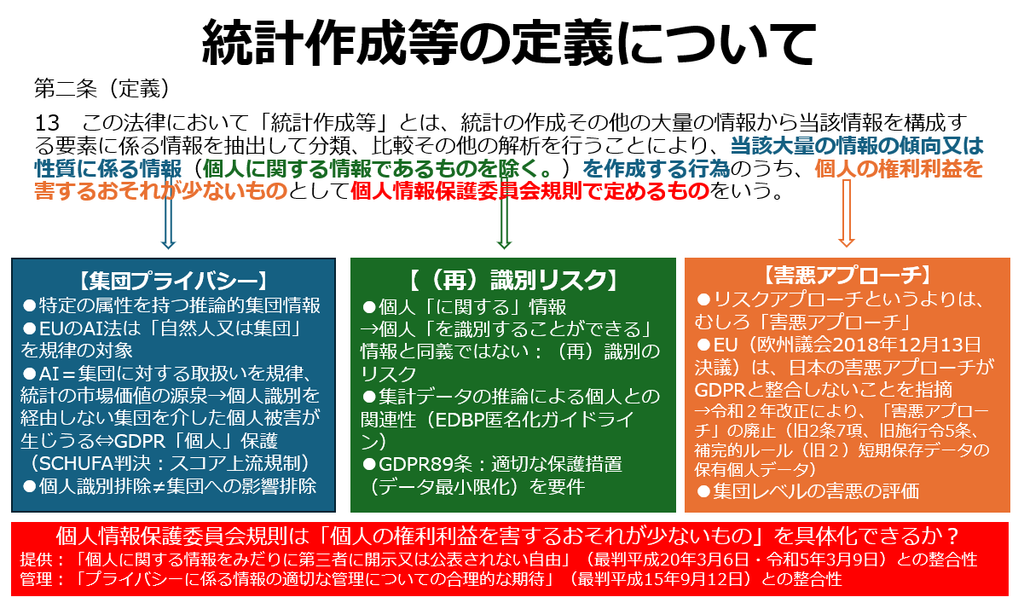
個人情報保護法における個人尊重の意味
統計特例が対象とする情報は、「個人に関する情報」ではないものとして定義されています。しかし、それによって個人への影響までなくなるわけではありません。
誰がどの集団に属するか、または当該集団にどのような性質があるかが推論され、その集団に対する価格、保険、雇用、広告、サービス等の取扱いが変われば、その影響は集団に属する個人にも及びうることになります。したがって、「個人に関する情報」でないことと、集団を介して個人に及ぶ影響を排除することは別問題です。
統計作成等では、大量の情報から集団の「傾向又は性質」が抽出されます。AI法5条が自然人のみならず、集団も規律の対象に含めているように、
大量のデータ → 集団の構成・性質の推論 → 個人の集団帰属の推定 → 評価・意思決定 → 個人・集団への影響
という連鎖的な構造を有しています。
統計特例はこの過程の上流に位置しますが、集団プライバシーの核心的問題は、下流の個人の集団帰属の推定や属性の帰属を通じて個人に結び付けられる点にあり、その結果として、個人に対する評価・意思決定が行われ、個人に影響を及ぼす点です(EU司法裁判所SCHUFA判決、参照)。
個人情報保護法における「個人の人格尊重」(個人情報保護法3条、憲法13条、参照)は、個人を集団から切り離された主体としてのみ捉えることを意味しません。データが構成する集団への帰属を媒介にした評価・意思決定が、結果として、「個人の人格尊重」を損なう場合も、その個人の保護に含まれうるのです。
AI時代の統計特例で問われていることは、個人に関しない情報が、集団を介して個人の評価や意思決定に重大な影響を及ぼすとき、いかにそれを「個人の人格尊重」の問題として捉えるかではないでしょうか。
参考資料
・集団プライバシーについては、Linnet Taylor, Luciano Floridi, Bart van der Sloot (eds), Group Privacy (Springer 2016). 本論は、同著の中にあるAlessandro Mantelero, ‘From Group Privacy to Collective Privacy: Towards a New Dimension of Privacy and Data Protection in the Big Data Era’の論文に依拠しています。
・EUのデジタル法における「集団」概念に着目し、集団救済を論じるものとして、Liubomir Nikiforov, ‘EU Collective Redress for Inferred Groups: Standing and Compensation under the GDPR, the Representative Actions Directive and the AI Act’ (2026) European Journal of Risk Regulation、また集団の権利を論じるものとして、Rainer Mühlhoff, ‘Predictive Privacy: Collective Data Protection in the Context of Artificial Intelligence and Big Data’ (2023) 10(1) Big Data &Societyがそれぞれ参考になります。
・GDPRの下で、上流の推論作用自体を規律対象とした事例として、Case C‑634/21, OQ v Land Hessen, ECLI:EU:C:2023:957(SCHUFA判決(石塚壮太郎「ドイツSchufaによるクレジットスコアリングは制限されるか」ジュリスト1595号))があります。同判決は、信用スコアの算出自体が「決定」となりうるため、下流の個別の意思決定と独立して規制対象となり得ることを示しています(なお、同判決は集団プライバシーを承認した判決ではありません)。
・ドイツ憲法裁判所の判例については、国勢調査判決(BVerfGE 65, 1, Rn. 92 und Rn.206(平松毅「自己情報決定権と国勢調査」ドイツ憲法判例研究会編『ドイツの憲法判例(第2版)』)、その後の判例としてRasterfahndung II判決(BVerfGE 115, 320(宮地基「ラスター捜査事件」ドイツ憲法判例研究会編『ドイツの憲法判例Ⅳ』)及び警察自動化データ分析判決(1 BvR 1547/19)(新井貴大「警察による自動化されたデータ分析と情報自己決定権」『自治研究』102号1巻)が参考になります。
・EDPBガイドラインについては、Guidelines 02/2026 on Anonymisation Version 1.0, Adopted on 07 July 2026 (public consultation)、参照。
・基準適合体制(30条の2、5項)に係る「リスク」を念頭に、国会審議において「本特例においては、統計情報等の作成のために提供されるデータについて、一律に個人情報の削除を求めるのではなく、提供元、提供先に漏えい等を生じた場合のリスク等に応じて適切に対応することで個人の権益の保護を図る制度設計としております」(衆・デジタル社会形成特委・令和8年5月21日(松本大臣))という指摘がありました。基準適合体制に係る漏えい等の「リスク」管理によって、集団的推論が個人に帰属されることによる権利利益への「害するおそれ」まで解消されるとは限らない点に注意が必要です。
・国会審議における「個人情報保護法ってかなり複雑にでき上がっている法律で、次から次と建て増しをしているような法律だと思います。 …きれいな形に一回見直してしまうということは、個人的な意見ですけど、私はありだと思っています」(参・デジタル社会形成特委・令和8年6月24日(松本大臣))という指摘は、次回見直し時の教訓とすべきかと思います。
How to cite 宮下紘 (2026). 集団プライバシー—改正個人情報保護法の統計作成等の特例について考える. Zenodo. https://doi.org/10.5281/zenodo.22532111
Miyashita, H. (2026). Group Privacy: On Japan's Statistical-Creation Exception under the 2026 Amendment to the Act on the Protection of Personal Information. Zenodo. https://doi.org/10.5281/zenodo.22532111
投稿者プロフィール

最新の投稿
 研究2026年9月4日集団プライバシー
- 研究2026年5月25日GDPR誕生日:デジタル立憲主義における「人間の条件」
- お知らせ2026年5月2日規制のデザインと不確実性:EUデジタルオムニバスの行方
 お知らせ2026年4月30日ホームページを開設しました。


